AWS障害をリアルタイムで確認する方法は?原因・対策まとめ


自社サービスにエラーが出た瞬間、まず確認したいのがAWS Health Dashboardです。
実際、2025年10月と2026年7月には国内外の多くのサービスに影響が及ぶ大規模障害が起き、原因の切り分けと初動対応の速さが被害の大きさを左右しました。
本記事では、障害発生時にリアルタイムで状況を確認する方法から、過去の代表的な障害事例、発生原因の構造、企業が取るべき対策、SLA・補償の仕組みまでを解説します。
【この記事はこんな人におすすめ】
- ・自社サービスの障害原因がAWS側にあるか切り分けたいシステム担当者
- ・過去の障害事例や再発防止策を知り、冗長化などの対策を検討したい方
- ・障害対応の経験を今後のキャリア・転職にどう活かせるか知りたいエンジニア

この記事のまとめ
- 障害確認はAWS Health Dashboardが基本
- 障害原因は物理・ソフトウェア・運用の3種に大別できる
- 冗長化と情報収集の習慣化が有効な備えになる
目次

4月時点
 8484
※2026年4月時点
AWSで障害が起きているか今すぐ確認する4つの方法
自社サービスに異常が出たとき、最初に確認したいのは公式のAWS Health Dashboardです。 これに加えてSNSやCloudWatchを組み合わせることで、状況をより早く正確に把握できます。
以下では、4つの確認手段の特徴と使い分け方を紹介します。
- AWS Health Dashboardの「サービスの状態」「アカウントの状態」で公式情報を見る
- X(旧Twitter)・Downdetectorで速報を集める
- CloudWatchで自社システムへの影響を特定する
- 確認方法の比較表(速報性・信頼性・用途)
AWS Health Dashboardの「サービスの状態」「アカウントの状態」で公式情報を見る
AWSの障害情報を確認する際の一次情報源は、AWS Health Dashboardの2つの画面です。
ひとつは「サービスの状態」で、リージョンやサービスごとの稼働状況をサインインせずに誰でも閲覧できます。もうひとつが「アカウントの状態」で、マネジメントコンソールにサインインして見る、自社アカウントに紐づく影響情報です。
かつて別々に提供されていたService Health DashboardとPersonal Health Dashboardは、2022年にこのAWS Health Dashboardへ統合されました。全体の障害の有無を知りたい場合は前者、自社リソースへの実際の影響を知りたい場合は後者という使い分けになります。
両者を混同すると、全体では障害が出ていても自社への影響はない、あるいはその逆といった誤認につながるため注意が必要です。
(参考:Amazon Web Services『AWS Health Dashboard を使用して AWS のサービス の状態を確認する』)
X(旧Twitter)・Downdetectorで速報を集める
AWS Health Dashboardの更新には多少のタイムラグが生じることがあります。そのため、公式発表前の初動段階ではSNSや障害報告サービスの活用が有効です。
AWSの公式アカウントの発信に加え、他の利用者が投稿する障害報告を横断的に見ると、影響範囲の広がりを早い段階でつかめます。
Downdetectorのような障害報告を集約するサービスも、報告件数の推移から障害の規模感を把握する手段として役立つでしょう。
ただし個人の投稿には誤情報も含まれるため、最終的な判断は必ず公式情報と突き合わせることが重要です。
CloudWatchで自社システムへの影響を特定する
AWS全体の障害と自社サービスの不具合は、必ずしも一致するとは限りません。
CloudWatchでエラーレートやレイテンシー、特定のAPI呼び出しの失敗率をあらかじめ監視しておくと、異常発生時に「AWS側の問題か、自社の設定・実装側の問題か」を切り分けやすくなります。
特定のリージョンやサービスに絞ったアラームを事前に設定しておけば、公式発表を待たずに影響範囲を推測できる点もメリットといえます。日頃からダッシュボードを整備しておくことが、初動の速さに直結します。
確認方法の比較表(速報性・信頼性・用途)
4つの確認手段には、それぞれ得意な場面があります。
用途に応じた使い分けが、正確な状況把握への近道です。
| 確認方法 | 速報性 | 信頼性 | 向いている場面 |
| AWS Health Dashboard (サービスの状態) |
△ | ◎ | 全体障害の公式確認 |
| AWS Health Dashboard (アカウントの状態) |
△ | ◎ | 自社アカウントへの影響確認 |
| X・Downdetector | ◎ | △ | 公式発表前の初動把握 |
| CloudWatch | ◎ | ○ | 自社システムの異常検知 |
【あわせて読みたい】AWSマネジメントコンソールの使い方はこちら⇓

\ レガシーな環境に悩んだら? /
障害発生時に情シス・エンジニアが取るべき初動対応フロー
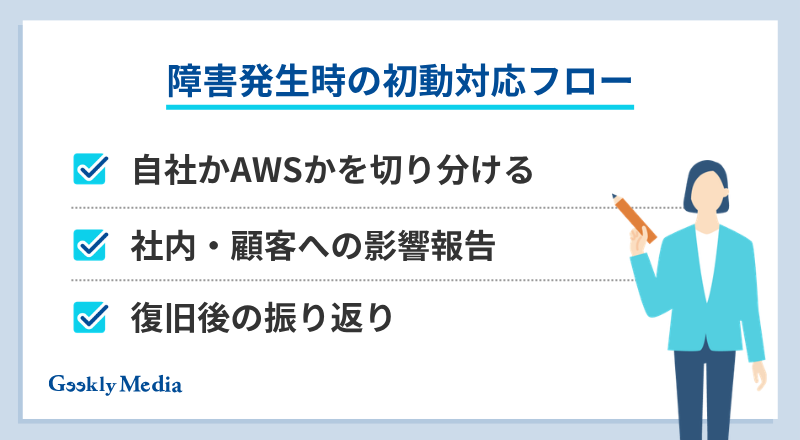
障害の発生を確認したあとは、原因の切り分けから報告、振り返りまでを順序立てて進めることが求められます。
ここでは初動対応の流れを3つのステップで整理します。
自社原因かAWS原因かを切り分ける
AWSでは、インフラの安全性をAWSが担い、OSやアプリケーションの設定を利用者が担う「責任共有モデル」が採用されています。
そのため障害発生時は、まずAWS Health Dashboardで該当リージョン・サービスにイベントが出ていないかを確認し、出ていなければ自社側の設定変更やデプロイ内容を疑うという順番が基本です。
デプロイ履歴やIaCの変更ログを直近から遡ると、原因特定のスピードが上がるでしょう。判断に迷う場合は、AWSサポートへの問い合わせも有効な選択肢です。
社内・顧客への影響報告で押さえるべきポイント
原因の切り分けと並行して欠かせないのが、経営層や顧客への状況報告です。
報告には「影響範囲」「発生時刻」「復旧見込み」「代替手段の有無」の4点を盛り込むことが基本になります。
特に復旧見込みが不明な段階では、無理に断定せず「現在調査中」であることを明示したうえで、次回の報告タイミングを伝えると信頼を保ちやすくなります。
テンプレートをあらかじめ用意しておけば、混乱した状況でも迅速に報告できるでしょう。
復旧後に行うべき振り返り(ポストモーテム)
障害対応は復旧して終わりではありません。
原因・対応の経緯・再発防止策を整理する「ポストモーテム」を行うことで、同種の障害への耐性を高められます。
振り返りの際は個人の責任追及ではなく、仕組みの改善に焦点を当てることが大切です。得られた知見はドキュメント化し、次回の対応フローに反映させましょう。
\ レガシーな環境に悩んだら? /
なぜAWSで障害は起きるのか?3つの原因分類
AWSの障害は、発生源によって大きく3つに分類できます。 それぞれの特徴を理解しておくと、原因の切り分けや対策の検討がしやすくなるでしょう。
- 物理的要因(データセンター・ネットワーク障害)
- 論理的・ソフトウェア要因(設定ミス・DNS障害)
- オペレーション要因(人為的ミス)
物理的要因(データセンター・ネットワーク障害)
物理的要因とは、データセンターの設備そのものに起因する障害です。
サーバーやストレージなどハードウェアの故障に加え、電源設備のトラブルや空調・冷却設備の不具合が代表例として挙げられます。
2019年8月に東京リージョンで起きた障害では、データセンターの制御システムの不具合で冷却が効かなくなり、一部のEC2インスタンスとEBSボリュームが停止しました。
AWSは複数のアベイラビリティゾーンにデータセンターを分散させていますが、単一施設内の設備障害は依然として起こり得るリスクといえます。
(参考:Amazon Web Services『東京リージョン (AP-NORTHEAST-1) における Amazon EC2 と Amazon EBS の事象概要』)
論理的・ソフトウェア要因(設定ミス・DNS障害)
近年の大規模障害で目立つのが、ソフトウェアやネットワーク設定に起因する論理的要因です。
特にDNSの名前解決に関する不具合は、単一の機能不全が連鎖的に多数のサービスへ波及しやすいという特徴があります。
2025年10月に米国東部リージョンで発生した大規模障害も、AWSの事後報告によれば、DynamoDBのDNS管理システムに潜んでいた競合状態が引き金でした。物理的な故障とは異なり、内部処理に起因するため事前の予兆がつかみにくく、影響範囲が広がりやすい点に注意が必要です。
(参考:Amazon Web Services『Summary of the Amazon DynamoDB Service Disruption in Northern Virginia (US-EAST-1) Region』)
オペレーション要因(人為的ミス)
デプロイ作業時の設定ミスや、運用手順の不備といった人為的な要因も、障害の主要な原因のひとつです。
自動化されたシステムであっても、変更を反映する作業自体には人の手が介在するため、ヒューマンエラーを完全になくすことはできません。
変更管理のプロセスや承認フローを整備し、影響範囲の大きい操作には段階的なロールアウトを取り入れると、リスクを下げられるでしょう。
\ レガシーな環境に悩んだら? /
【年表】過去に発生した代表的なAWS障害事例
過去の障害事例を振り返ると、自社対策の優先順位を検討しやすくなります。
ここでは東京リージョンと海外リージョン、直近2件の大規模障害に分けて整理しました。
東京リージョン(ap-northeast-1)の主な障害一覧
東京リージョンでも、これまでに複数回の障害が発生してきました。AWSが事後報告を公開している代表的な事例は以下のとおりです。
| 発生時期 | 主な影響サービス | 概要 |
| 2019年8月 | EC2・EBS(RDSなどにも波及) | データセンターの制御システムの不具合で冷却設備が停止し、単一アベイラビリティゾーンの一部が影響を受けた |
| 2021年9月 | AWS Direct Connect | ネットワーク機器のOSに潜在していた不具合により、Direct Connectロケーションから東京リージョンへの接続が断続的に失敗した |
2019年8月の事象は12時36分ごろから発生し、冷却設備の復旧は15時21分、大部分のインスタンスの復旧は18時30分ごろまでかかりました。2021年9月の事象も7時30分から13時42分までと半日近く続いています。
データセンター設備とネットワーク機器、いずれのトラブルでも復旧には数時間単位の時間がかかるという点は、代替手段を用意するうえで押さえておきたい事実です。
(参考:Amazon Web Services『AWS Post-Event Summaries』)
海外リージョンの主な障害一覧
日本国内の利用者にも影響が及ぶという意味では、海外リージョン、とりわけ米国東部(バージニア北部)リージョンの障害も重要視されています。
| 発生時期 | 主な影響サービス | 概要 |
| 2020年11月 | Kinesis Data Streamsほか | フロントエンドサーバーがOSのスレッド数の上限に達したことによる不具合 |
| 2021年12月 | EC2のAPIなど多数のサービス | 内部ネットワークの自動化処理に起因する大規模障害 |
| 2023年6月 | Lambda・STS・マネジメントコンソールほか | Lambdaのフロントエンドで容量のしきい値を超え、潜在していた不具合が顕在化した |
| 2025年10月 | DynamoDBほか多数のサービス | DNS管理システムの競合状態により、エンドポイントのDNSレコードが空になった |
米国東部リージョンは利用者数が多く、このリージョンの障害は国内のWebサービスにも波及しやすい傾向があります。
(参考:Amazon Web Services『AWS Post-Event Summaries』)
2025年10月の大規模障害と2026年7月のCloudFront障害
直近2件の障害は、いずれも広範囲に影響が及びました。
2025年10月の障害は、米国東部リージョンで10月19日23時48分から10月20日14時20分(米国太平洋時間)にかけて発生したものです。AWSの事後報告によると、DynamoDBのDNS管理システムで競合状態が起こり、リージョンのエンドポイントからIPアドレスがすべて消えたことが発端でした。
その影響はEC2の新規インスタンス起動やNetwork Load Balancer、Lambda、STSなど広範囲に及び、国内外の多数のサービスで接続エラーが確認されています。
2026年7月の障害は、日本時間の7月16日16時45分ごろから始まりました。CloudFrontの「VPCオリジン」接続を利用する環境でエラーが増加し、国内ではPayPayなどのサービスにも影響が出たと報じられています。
いずれのケースでも、AWS Health Dashboardでの状況確認と、自社側での代替経路の検討が復旧までの時間を左右する要素となりました。
(参考:Amazon Web Services『Summary of the Amazon DynamoDB Service Disruption in Northern Virginia (US-EAST-1) Region』)
\ レガシーな環境に悩んだら? /
AWS障害への対策方法
AWS障害の影響を最小限に抑えるには、設計・運用の両面から備えることが欠かせません。 ここでは代表的な4つの対策を紹介します。
- マルチAZ・マルチリージョン構成による冗長化
- 疎結合アーキテクチャとDesign for Failure
- IaC・カオスエンジニアリングで耐障害性を検証する
- 監視・アラート体制と障害情報の収集を習慣化する
マルチAZ・マルチリージョン構成による冗長化
単一のアベイラビリティゾーンにシステムを集中させると、そのゾーンで障害が起きた際にサービス全体が停止するリスクが高まります。
まず検討したいのは、複数のアベイラビリティゾーンにリソースを分散させる「マルチAZ構成」です。
さらに可用性を高めたい場合は、複数のリージョンにまたがってシステムを配置する「マルチリージョン構成」も選択肢になるでしょう。
ただし構成が複雑になるほど運用コストも増えるため、事業の重要度に応じた設計が求められます。
疎結合アーキテクチャとDesign for Failure
「障害は必ず起きるもの」という前提に立って設計する考え方が「Design for Failure」です。
コンポーネント間の依存を減らし、ひとつのサービスに不具合が生じても全体が止まらない疎結合な構成にしておくことがポイントになります。
キューやメッセージングサービスを介して処理を非同期化すると、一時的な障害の影響を吸収しやすくなるでしょう。
IaC・カオスエンジニアリングで耐障害性を検証する
構成管理をコード化するIaC(Infrastructure as Code)を導入すると、障害発生時の環境復旧を迅速かつ再現性高く行えます。
さらに一歩進んだ手法として、意図的にシステムへ障害を発生させて耐性を検証する「カオスエンジニアリング」も注目されています。
本番相当の環境で疑似的な障害を起こし、想定していなかった弱点を事前に洗い出せる点が大きなメリットです。
監視・アラート体制と障害情報の収集を習慣化する
どれほど堅牢な構成を組んでも、異常への気づきが遅れれば被害は拡大します。
CloudWatchなどによる監視体制を整え、閾値を超えた際に担当者へ即座に通知が届く仕組みを構築しておくことが重要です。
加えて、AWS Health DashboardやSNSでの障害情報を日常的にウォッチする習慣も、初動の速さにつながります。技術的な対策と情報収集の習慣化は、いずれも欠かせない両輪といえるでしょう。
\ レガシーな環境に悩んだら? /
AWS障害の補償・SLAはどうなるのか
障害によって生じた損失にどのような補償があるのかは、多くの利用者が気になるポイントでしょう。ここではSLAの仕組みと責任範囲を解説します。
- AWSのSLAとサービスクレジットの仕組み
- 責任共有モデルを理解しておくべき理由
AWSのSLAとサービスクレジットの仕組み
AWSは主要なサービスごとにSLA(サービス品質保証制度)を定めており、月間稼働率が規定の水準を下回った場合、利用者は「サービスクレジット」を申請できます。
たとえばAmazon EC2のリージョン単位のSLAでは、月間稼働率99.99%を下回ると10%、99.0%を下回ると30%、95.0%を下回ると100%のクレジットが対象になります。
クレジットは自動的に適用されるものではなく、事象の発生から2請求サイクル以内にAWS Support Centerから申請する必要がある点に注意が必要です。あくまで利用料金に充当されるもので、事業上の損失そのものを補う制度ではありません。
(参考:Amazon Web Services『Amazon Compute Service Level Agreement』)
責任共有モデルを理解しておくべき理由
AWSの責任範囲を正しく理解するうえで欠かせないのが「責任共有モデル」です。
このモデルでは、データセンターやネットワークなどインフラ部分の安全性はAWSが責任を負う一方、OSの設定やアプリケーションの実装、アクセス権限の管理などは利用者側の責任とされています。
したがって、障害の原因がAWS側の設備・サービスにある場合はSLAの対象になり得る半面、自社側の設定ミスに起因する不具合は対象外です。
この境界線を理解しておくことが、補償請求と再発防止策の検討の両方に役立つでしょう。
(参考:Amazon Web Services『責任共有モデル』)
\ レガシーな環境に悩んだら? /
障害対応の経験はエンジニアのキャリア・年収にどう影響するか
障害対応の経験は、単なる業務上の負担にとどまらず、転職市場で評価される実務スキルのひとつです。 ここではGeekly(ギークリー)が持つ転職支援の知見から、キャリアへの影響を解説します。
インシデント対応経験は転職でどう評価されるか
障害対応やインシデント管理の経験は、選考の場で「実践的な問題解決力」を示す材料として評価される傾向にあります。
特に、原因調査から復旧、再発防止策の立案までを一貫して担った経験は、SRE(Site Reliability Engineering)やクラウドインフラ関連のポジションで重視されやすい項目です。
障害時の冷静な判断力やチーム内での連携経験も、評価されるポイントとして挙げられます。
SRE・クラウドエンジニアの求人動向
クラウド活用の広がりに伴い、システムの安定稼働を支えるSREやクラウドインフラエンジニアの求人ニーズは高い水準で推移しています。
特に大規模障害への対応経験や、マルチクラウド・マルチリージョン構成の設計経験を持つエンジニアは、採用市場において引き合いが強い傾向です。
今後もクラウド活用の拡大に伴い、こうしたスキルセットへの需要は続いていくと考えられます。
職務経歴書での障害対応経験のアピール方法
障害対応の実績を職務経歴書に書く際は、「発生した事象」「担当した役割」「取った対応」「結果として得られた改善」の4点を具体的に記述するとよいでしょう。
数値で示せる部分(復旧までの時間短縮、再発件数の減少など)があれば、あわせて盛り込むと説得力が増します。抽象的な表現にとどめず、実務での再現性が伝わる書き方を意識しましょう。
今のスキルの市場価値を無料で診断してみよう
\ 市場価値を知りたいエンジニア必見! /

かんたん
3分!
無料診断してみる

「転職する前にエンジニアとしての市場価値を把握したい!」
「年収を上げたいけど自分の適正年収が分からない…」
「今のスキルでどこまで年収アップできるんだろう?」
仕事量が多いのに周りと比べて年収が低い、エンジニアスキルが評価されにくくて給料が上がりにくい、転職したいけど今より年収が落ちないか不安、など、エンジニアにとって「年収」に関する悩みは多いですよね。
年収のことで悩んだら、一度ご自身の年収の現在地と年収アップ予想額を調べてみませんか?
IT・Web・ゲーム業界特化、特にエンジニア転職に強い転職エージェントの分析を基にした年収診断で現在地から目指せる年収を知ることで、この先どうするか納得のいく決断ができるでしょう。
\ 年収、もっと上がるかも? /
年収約120万円アップ!年収診断の利用から約2週間以内に転職成功した方の例
- ご年齢:30代
- ご経歴:プロジェクトマネージャー⇒アプリエンジニア
- 勤務地:西日本⇒東京へ転職
- 転職期間:2週間以内に転職成功
Aさんは、スピード転職に成功、かつ年収を約120万円アップすることに成功しています。
もともとアプリエンジニアとしてのご経験もお持ちで、年収診断を行った結果、同職種・同年代のボリュームゾーンより年収が下回っていることから年収を上げたいとお考えになり、転職で年収アップを成功させました。また、開発に携わりたいという希望も転職により叶えることができました。
【あわせて読みたい】転職で年収アップに成功したエンジニアの事例はこちら⇓

「IT人材年収診断」ご利用の流れ
「IT人材年収診断」は4つのステップで完結!
STEP1:以下のボタンから年収診断のページへ
STEP2:年収診断のページから氏名と連絡先を入力してスタート
STEP3:プロフィールと簡単な職務経歴を入力して診断
STEP4:ご自身の年収の現在地を把握
診断後は、年収が上がる求人や、ご希望に沿った求人のご紹介、IT職種を熟知したキャリアアドバイザーに転職の相談をすることもできます。是非一度、現在の年収からのアップ予想額をご確認ください。
\ 年収、もっと上がるかも? /
AWS以外のクラウドは障害に強いのか(Azure・GCPとの比較)
AWSに限らず、AzureやGCPといった主要クラウドでも大規模障害は過去に発生しています。特定のクラウドが絶対的に障害に強いとはいい切れないのが実情です。
- マルチクラウド戦略のメリットと導入のハードル
マルチクラウド戦略のメリットと導入のハードル
単一のクラウドに依存するリスクを分散させる手段として、複数のクラウドを併用する「マルチクラウド戦略」が注目されています。
一方のクラウドで障害が起きても、もう一方でサービスを継続できる点が最大のメリットです。 ただし、クラウドごとに異なるAPIや運用ノウハウへの対応が必要になるため、構築・運用コストは単一クラウドに比べて増加します。
すべてのシステムをマルチクラウド化するのではなく、事業継続性が特に重要なコンポーネントに絞って適用するという考え方が現実的でしょう。
\ レガシーな環境に悩んだら? /
AWS障害に関するよくある質問
最後に、AWS障害について多い疑問について回答します。
- AWSはなぜ障害が起きるのですか?
- AWSの障害はどのくらいの頻度で起きていますか?
- AWS障害の影響を受けた場合、補償はありますか?
- AWSとAzure・GCPはどちらが障害に強いですか?
- 障害対応ができるエンジニアの需要は高いですか?
- 個人でもAWS障害の影響を受けることはありますか?
Q1:AWSはなぜ障害が起きるのですか?
物理的要因(データセンター設備の故障)、論理的・ソフトウェア要因(設定ミスやDNS関連の不具合)、オペレーション要因(人為的ミス)の3つが主な原因として挙げられます。
Q2:AWSの障害はどのくらいの頻度で起きていますか?
軽微な事象は日常的に発生しています。一方、AWSが事後報告(Post-Event Summary)を公開するような大規模障害は、2011年以降で十数件です。
Q3:AWS障害の影響を受けた場合、補償はありますか?
SLAで定められた稼働率を下回った場合、利用料金に充当できるサービスクレジットを申請できます。ただし事業上の損失を補う制度ではなく、自社側の設定ミスに起因する障害も対象外です。
Q4:AWSとAzure・GCPはどちらが障害に強いですか?
いずれのクラウドでも大規模障害は発生しており、特定のクラウドが一方的に優れているとはいえません。重要なのは単一クラウドへの依存を減らす設計です。
Q5:障害対応ができるエンジニアの需要は高いですか?
SREやクラウドインフラエンジニアの求人ニーズは高い水準にあり、障害対応の実務経験は転職市場で評価されやすい傾向にあります。
Q6:個人でもAWS障害の影響を受けることはありますか?
AWSを基盤とする多数のWebサービスやアプリが影響を受けるため、直接AWSを利用していない個人でも、日常的に使うサービスを通じて影響を受ける場合があります。
【あわせて読みたい】クラウド領域の年収相場はこちら⇓

\ レガシーな環境に悩んだら? /
AWS障害への理解を深め、次のキャリアを考えるならGeekly
AWS障害に備える基本は、AWS Health Dashboardをはじめとする複数の確認手段を組み合わせ、原因を物理・ソフトウェア・運用の3分類で捉えることです。
そのうえで冗長化や疎結合設計、監視体制の整備を積み重ねていくと、影響を小さく抑えられます。SLAや責任共有モデルを理解しておけば、補償の確認や社内報告の場面でも判断に迷いにくくなるでしょう。
「障害対応の経験をキャリアに活かしたい」
「SREやクラウドエンジニアに挑戦したい」
「インフラ領域で年収を上げたい」
などのキャリアのお悩みは是非、「IT・Web業界の知見が豊富なキャリアアドバイザー」にご相談ください!
IT特化の転職エージェントのGeekly(ギークリー)なら、専門職種ならではのお悩みも解決できる専任のキャリアアドバイザーがカウンセリングから入社後まで完全無料で全面サポートいたします!
転職しようか少しでも悩んでいる方は、お気軽に以下のボタンからご相談ください。
\ レガシーな環境に悩んだら? /
イチ押しの求人特集!
この記事の監修者
-

-
5年間インフラエンジニアとして新規顧客提案や既存顧客への提案〜運用保守業務を経験。業務を行う中で人材業界へ興味を持ち、22年1月国家資格キャリアコンサルタントを取得。現在、資格を活かしキャリアアドバイザーとしてエンジニアの転職支援を行っております。
この記事の執筆者
-
-
主にIT・Web・ゲーム業界の転職事情に関する有益な情報を発信するメディアの編集部です。転職者であれば転職市場や選考での対策、企業の採用担当者様であればIT人材の流れ等、「IT業界に携わる転職・採用」の事情を提供していきます。


あわせて読みたい関連記事
同じカテゴリの新着記事